Satu Reel berdurasi satu menit bisa menjelaskan topik yang rumit dengan ilustrasi bergerak, suara narasi, dan sumber yang tampil di layar. Panduan ini menyusun alur yang sama dari nol: riset, hook, naskah, scene plan, visual AI, suara tanpa rekaman, subtitle, render, sampai caption. Polanya dibedah dari 12 Reel yang terkait akun @taugaksih31, dan semua template di bawah bisa langsung disalin.
Panduan ini terinspirasi oleh Reel publik @taugaksih31 dan tidak berafiliasi dengan akun itu. Tidak ada video atau frame mereka yang diunggah ulang di sini: Reel di atas dimuat langsung dari Instagram, sisanya hanya ditautkan di Lampiran A. Visual lain di halaman ini dibuat sendiri dari data yang diukur. Catatan jujur sebelum mulai: dari 12 Reel itu, alat yang dipakai pembuatnya hampir tidak terlihat. Bagian 1 memisahkan apa yang terbukti, apa yang disimpulkan, dan apa yang cuma saran.
1. Yang terlihat, yang disimpulkan, yang disarankan
Setiap klaim di panduan ini punya salah satu dari tiga label.
- Terlihat: ada di transkrip, caption, metadata file, atau frame awal Reel. Contoh: median durasi 73 detik, atau caption satu Reel yang menulis “VO & animasi dibantu AI”.
- Inferensi: kesimpulan penulis dari yang terlihat. Contoh: sumber di layar kemungkinan dibuat sebagai lapisan teks terpisah.
- Saran: cara kerja yang direkomendasikan di sini, bukan klaim tentang kreatornya. Contoh: seluruh script dan template di bagian 7 sampai 13.
Yang tidak bisa dipastikan dari 12 Reel itu:
- Alat atau model yang dipakai untuk gambar, animasi, dan suara. Satu-satunya pernyataan keterlibatan AI dari akun @taugaksih31 adalah caption “VO & animasi dibantu AI” di satu Reel, yang berarti dibantu, bukan sepenuhnya dibuat AI.
- Apakah suaranya TTS, suara manusia, atau campuran. Hanya Reel yang caption-nya menyebut “VO … dibantu AI” yang memberi petunjuk.
- Musik latar. Analisis ini membaca transkrip, caption, metadata, dan frame awal, bukan spektrum audio.
- Biaya dan waktu produksi. Satu Reel memang menyebut lama dan pemakaian kuota saat menguji dua model, tetapi itu hasil uji model, bukan alur produksi kanal.
Catatan kredit akun. Menurut metadata unduhan, 7 dari 12 Reel diunggah akun @taugaksih31, 4 oleh @jakintegral, dan 1 oleh @yourewerethere. Tiga caption @taugaksih31 menulis “Dibikin oleh @jakintegral”. Data yang ada tidak cukup untuk memastikan hubungan kolaborasi di antara akun-akun itu. Reel dari @yourewerethere adalah film fantasi AI yang captionnya menyebut dibuat penuh dengan AI memakai model video tertentu. Itu klaim akun tersebut, bukan akun lain, dan satu-satunya klaim “seluruhnya dibuat AI” di 12 Reel. Kredit per Reel ada di Lampiran A.
2. Pola yang bisa dihitung dari 12 Reel
Angka otomatis dihitung dari file video dan transkrip lewat scripts/guides/taugaksih31-stats.py. Angka bertanda “manual” dikodekan dari transkrip, caption, dan contact sheet yang hanya mencakup sekitar 10 detik pertama tiap Reel, jadi bukan gambaran penuh tiap video.
- Rasio layar (otomatis): 8 vertikal 9:16, 1 berukuran 3:4, 3 landscape 16:9.
- Durasi (otomatis): median 73 detik, terpendek 37, terpanjang 175. Sembilan Reel berdurasi 57 sampai 108 detik.
- Narasi (otomatis): 11 Reel bernarasi. Median 143 kata dan 123 kata per menit, dengan rentang 113 sampai 141.
- Kata pertama (otomatis): muncul dalam 1,0 detik pertama di 11 dari 11 Reel bernarasi.
- Penutup narasi (manual): 5 berupa pertanyaan ke penonton, 4 berupa ajakan (simpan, ikuti, tonton video panjang, subscribe), 2 tanpa ajakan.
- Sumber (manual dan otomatis): 7 dari 12 menampilkan nama sumber, tautan, atau tanggal di frame awal. 3 caption memuat kata “Sumber”.
- Gaya visual (manual): 9 ilustrasi 2D datar, 1 tangkapan layar dan logo, 1 tipografi dan logo, 1 video sinematik.
- Frasa khas (manual): “Tau gak sih” muncul di 5 dari 7 Reel yang diunggah @taugaksih31.
- Hashtag (otomatis): median 5. Sembilan caption memakai 4 sampai 6.
- Arah ke video panjang (manual): 4 caption mengarahkan ke YouTube lewat link di bio.
- Pengungkapan AI (otomatis, dibaca manual): 1 dari 12 caption, yaitu Reel tarif Haiku 5.5.
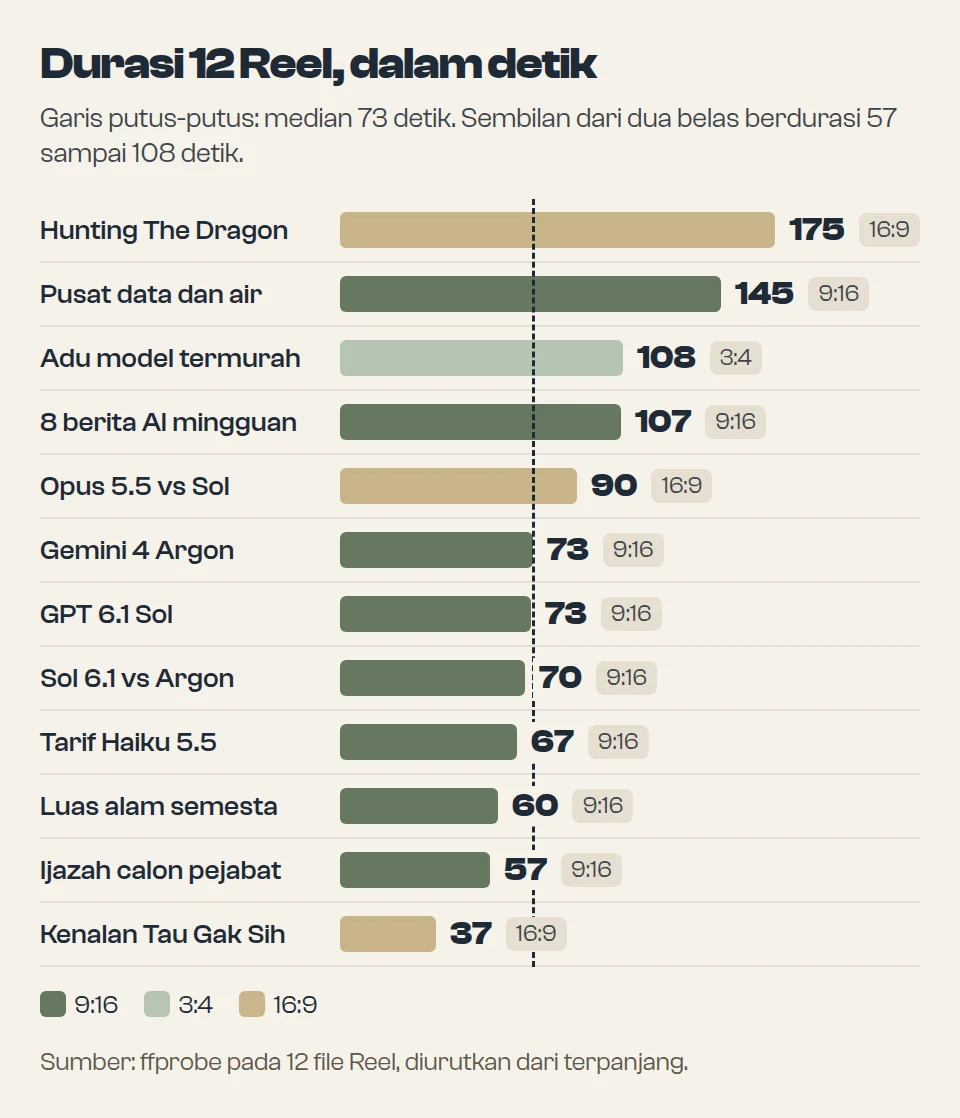
Dua hal yang bisa dipakai dari angka-angka ini. Pertama, format ini lebih panjang dari klip pendek biasa, jadi naskahnya harus padat dan terstruktur. Kedua, hampir semua Reel langsung berbicara di detik pertama, jadi hook ditulis sebelum visual dibuat. Angka-angka itu menggambarkan 12 Reel, bukan aturan platform dan bukan jaminan jangkauan.
3. Peta alur 12 tahap
- Riset topik: lembar fakta bersumber. Selesai bila tiap klaim punya sumber dan tanggal.
- Hook: satu kalimat pembuka terpilih. Selesai bila bisa diucapkan dalam sekitar 6 detik.
- Naskah: narasi per beat. Selesai bila kata per detik masuk rentang.
- Scene plan:
scenes.json. Selesai bilaplan_check.pytanpa ERROR. - Aset visual AI:
scene-01.pngdan seterusnya. Selesai bila satu gambar membawa satu pesan, rasio 9:16. - Suara TTS:
voice.wav. Selesai bila tiap scene muat di durasinya. - Motion: klip per scene. Selesai bila gerak halus dan tanpa loncat.
- Subtitle:
subtitle.srt. Selesai bila terbaca sekali lihat. - Musik dan SFX: musik di bawah suara. Selesai bila suara tetap jelas.
- Render:
final.mp4. Selesai bila 1080x1920, H.264, AAC. - QA: checklist lulus. Selesai bila video ditonton penuh di ponsel.
- Publikasi: caption, sumber, label AI. Selesai bila fakta di caption sama dengan di video.
Tahap 1 sampai 3 adalah Terlihat sebagian: tiap Reel faktual memuat sumber, hook di detik pertama, dan beat yang berurutan. Tahap 4 sampai 12 adalah Saran. Struktur tahap sebagian adalah Inferensi dari hasil akhirnya.
4. Riset topik dan sumber
Terlihat: tujuh Reel menampilkan sumber di layar, misalnya nama penerbit dan tanggal, dan satu Reel menjelaskan batas klaimnya sendiri. Reel soal pusat data dan air menyebut apa yang tidak dibuktikan studinya sebelum menyimpulkan.
Saran: satu klaim, satu sumber primer, satu tanggal. Angka ditulis persis seperti di sumber. Kalau sumber tidak menjawab sesuatu, tulis “tidak diketahui” dan jangan isi dengan tebakan. Pakai lembar fakta ini sebagai satu-satunya bahan naskah.
TOPIK: [isi topik]
TANGGAL RISET: [YYYY-MM-DD]

| # | Klaim (persis seperti sumber) | Angka dan satuan | Sumber primer (URL) | Tanggal terbit | Syarat atau batas |
| --- | --- | --- | --- | --- | --- |
| 1 | | | | | |
| 2 | | | | | |
| 3 | | | | | |

TIDAK DIKETAHUI (ditanyakan penonton, tidak dijawab sumber):
-

JANGAN DIKLAIM (tidak ada sumbernya):
-
Kalau memakai model teks untuk merangkum sumber, beri bahan lewat tempel teks, bukan lewat ingatan model. Prompt ini bisa disalin:
Kamu membantu menyusun lembar fakta untuk video edukasi 60 detik.

Bahan sumber (hanya ini yang boleh dipakai, jangan tambah dari ingatanmu):
[TEMPEL TEKS SUMBER 1, URL, DAN TANGGAL TERBIT]
[TEMPEL TEKS SUMBER 2, URL, DAN TANGGAL TERBIT]

Topik: [TOPIK]

Tugas:
1. Ekstrak 5 sampai 8 klaim terpenting untuk penonton awam.
2. Tulis tiap klaim persis seperti di sumber: angka, satuan, tanggal, dan syaratnya.
3. Sebutkan sumber mana dan kutip kalimat aslinya.
4. Tandai klaim yang hanya berlaku pada kondisi tertentu atau hanya estimasi.
5. Tulis TIDAK DIKETAHUI untuk hal yang wajar ditanyakan penonton tetapi tidak dijawab sumber. Jangan menebak.

Format: tabel dengan kolom Klaim | Sumber | Kalimat asli | Syarat atau batas.
Setelah model menjawab, buka tiap sumber dan cocokkan angkanya sendiri. Model bisa salah menyalin.
5. Hook
Terlihat: Reel-reel itu mulai berbicara hampir seketika, dan pembukanya jatuh ke beberapa pola yang berulang: frasa “Tau gak sih”, klaim yang diikuti jebakan, pertanyaan kontras, dan pertanyaan langsung.
Lima rumus berikut adalah Saran yang diturunkan dari pola itu. Isi dengan faktamu sendiri.
- Tau gak sih: “Tau gak sih, [fakta yang berlawanan dengan dugaan umum]?” Pola serupa terlihat di Reel tarif Haiku 5.5 dan Reel luas alam semesta.
- Klaim dan jebakan: “[Hal yang terdengar bagus], tapi ada jebakannya.” Terlihat di Reel tarif Haiku 5.5.
- Pertanyaan kontras: “Kalau [A] hampir sama, kenapa [B] beda jauh?” Terlihat di Reel Sol 6.1 vs Argon.
- Pertanyaan langsung: “Bisa nggak [X] [berdampak ke Y]?” Terlihat di Reel pusat data dan air.
- Kok sudah: “[Hal baru] baru [waktu singkat], kok sudah ada [versi baru]?” Terlihat di Reel GPT 6.1 Sol.
Cek hook sebelum lanjut: satu ide, bisa diucapkan sekitar 6 detik, dan tidak menjanjikan sesuatu yang naskahmu tidak buktikan. Reel tarif Haiku 5.5 menghabiskan sekitar 6 detik untuk hook-nya. Itu satu contoh, bukan batas.
Tulis 10 kalimat hook berbahasa Indonesia santai untuk video 60 detik tentang: [TOPIK].

Fakta yang boleh dipakai (jangan tambah fakta lain):
[TEMPEL LEMBAR FAKTA]

Aturan:
- Maksimal 18 kata per hook, bisa diucapkan sekitar 6 detik.
- Pakai rumus berbeda untuk tiap dua hook: "Tau gak sih", klaim dan jebakan, pertanyaan kontras, pertanyaan langsung, "kok sudah".
- Jangan menjanjikan hasil, angka, atau jaminan yang tidak ada di lembar fakta.
- Jangan pakai kata "rahasia", "gila", atau "wajib".
- Setelah tiap hook, tulis nomor klaim di lembar fakta yang menopangnya.
6. Naskah
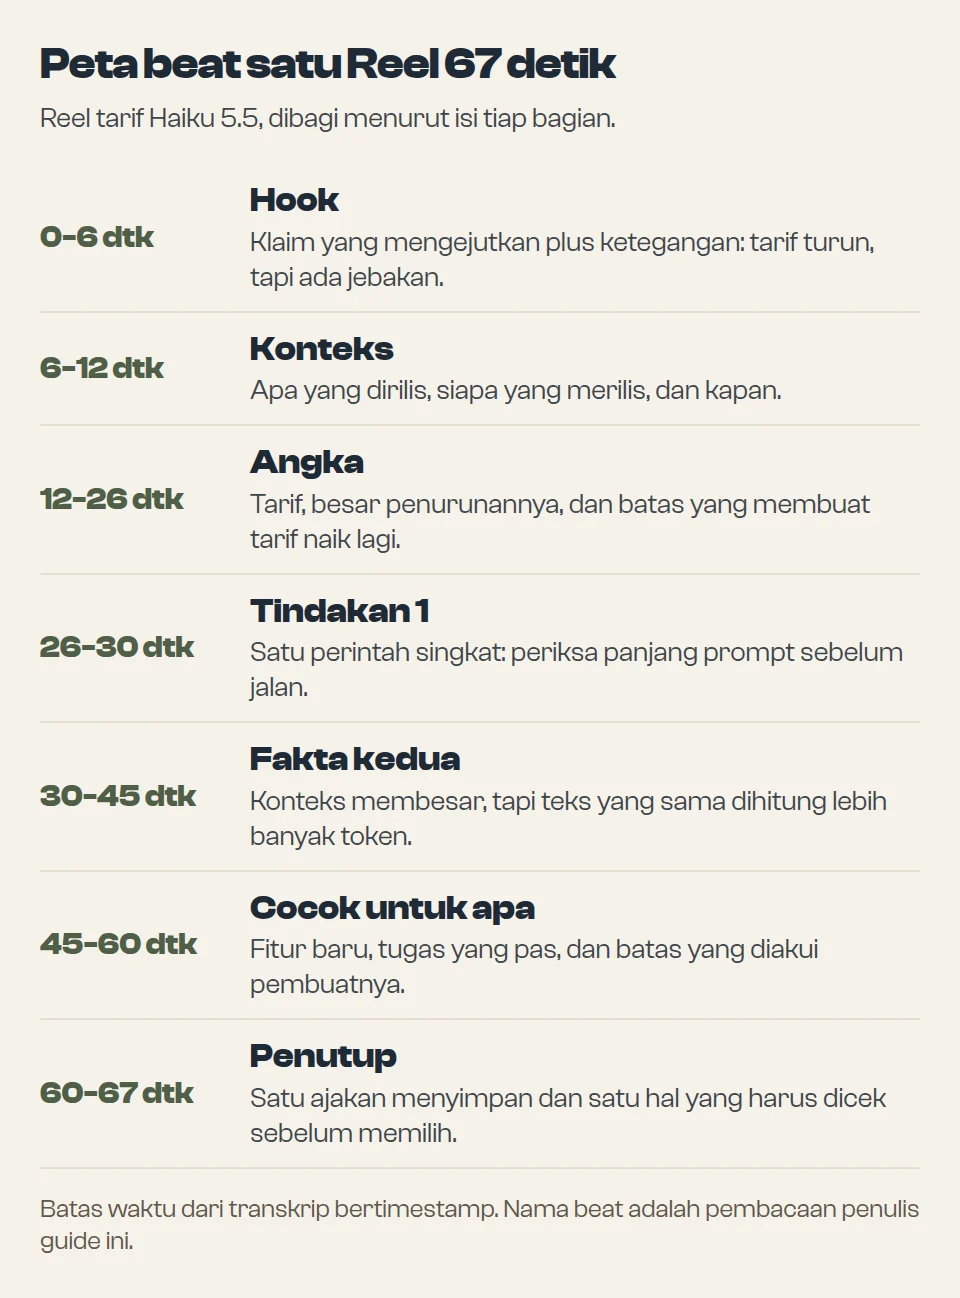
Terlihat: pada Reel itu, kalimat pertama berisi klaim dan ketegangan, angka muncul sekitar detik 12 sampai 26, dan Reel ditutup dengan satu ajakan menyimpan. Reel lain memakai beat yang mirip: konteks, bukti, batas, lalu pertanyaan atau ajakan.
Saran: pakai urutan hook, konteks, bukti, tindakan, batas, penutup. Targetkan sekitar 2 kata per detik, sesuai median 123 kata per menit di 12 Reel. Untuk 60 detik, itu sekitar 110 sampai 140 kata. Tulis angka sebagaimana diucapkan dan eja nama merek sesuai lafal, supaya TTS tidak salah baca.
Tulis naskah narasi video 60 detik dalam bahasa Indonesia santai tentang: [TOPIK].

Hook terpilih: [TEMPEL HOOK]
Lembar fakta (hanya ini yang boleh dipakai):
[TEMPEL LEMBAR FAKTA]

Struktur, satu paragraf per beat:
1. Hook (maksimal 18 kata)
2. Konteks: apa, siapa, kapan
3. Bukti: angka atau fakta inti dengan satuannya
4. Tindakan: satu hal yang bisa dilakukan penonton
5. Batas: kapan penjelasan ini tidak berlaku
6. Penutup: satu pertanyaan atau ajakan

Aturan:
- Total 110 sampai 140 kata.
- Kalimat pendek, satu ide per kalimat, kata sehari-hari.
- Jangan ada klaim yang tidak ada di lembar fakta.
- Tulis angka seperti diucapkan (misalnya "seratus ribu", "sembilan puluh persen").
- Tandai [SUMBER: nomor klaim] di akhir kalimat yang memuat fakta.
- Jangan pakai pengulangan, kata promosi, atau janji hasil.
Setelah naskah jadi, kirim satu prompt pemeriksa ke model yang sama atau model lain:
Periksa naskah ini terhadap lembar fakta.

Naskah:
[TEMPEL NASKAH]

Lembar fakta:
[TEMPEL LEMBAR FAKTA]

Daftar setiap kalimat yang memuat klaim, lalu tulis salah satu: COCOK, ANGKA BERBEDA, TIDAK ADA DI LEMBAR FAKTA, atau TERLALU PASTI. Jangan memperbaiki naskah, hanya melaporkan.
7. Scene plan yang bisa dicek mesin
Scene plan mengubah naskah menjadi daftar scene dengan durasi, gerak kamera, teks layar, dan prompt visual. Dengan format JSON, jumlah kata per detik dan kelengkapan sumber bisa dicek otomatis.
Contoh scenes.json (topik contoh tentang es batu, dengan dua sumber sengaja dikosongkan supaya terlihat peringatannya):
{
  "title": "Kenapa es batu mengapung",
  "fps": 30,
  "min_seconds": 45,
  "max_seconds": 75,
  "scenes": [
    {"id": 1, "beat": "hook", "seconds": 7, "motion": "zoom-in",
     "narration": "Tau gak sih, es batu mengapung bukan karena ringan, tapi karena sesuatu yang aneh terjadi pada air.",
     "on_screen": "Es mengapung. Kenapa?",
     "visual_prompt": "Gelas bening berisi es batu mengapung di air, kamera dekat, latar krem polos, ilustrasi datar, tanpa teks",
     "source": ""},
    {"id": 2, "beat": "konteks", "seconds": 6, "motion": "pan-right",
     "narration": "Hampir semua zat menyusut saat membeku. Air melakukan kebalikannya: volumenya justru bertambah.",
     "on_screen": "Zat lain menyusut. Air memuai.",
     "visual_prompt": "Dua wadah sejajar, kiri zat menyusut, kanan air membeku memuai, ilustrasi datar, latar krem, tanpa teks",
     "source": "TODO: tautan sumber untuk sifat air saat membeku"},
    {"id": 3, "beat": "fakta", "seconds": 9, "motion": "zoom-out",
     "narration": "Saat membeku, molekul air tersusun dalam kisi yang renggang. Ruang kosongnya membuat es kurang padat dibanding air cair.",
     "on_screen": "Es lebih renggang",
     "visual_prompt": "Diagram sederhana molekul air cair rapat di bawah dan kisi es renggang di atas, ilustrasi datar, tanpa label",
     "source": "TODO: tautan sumber untuk kerapatan es dan air"},
    {"id": 4, "beat": "analogi", "seconds": 9, "motion": "pan-left",
     "narration": "Bayangkan kursi di ruang tunggu. Kalau semua duduk rapat, muat banyak orang. Kalau semua pakai jarak, ruangnya terasa penuh.",
     "on_screen": "Rapat vs berjarak",
     "visual_prompt": "Dua deret kursi ruang tunggu, satu rapat penuh, satu berjarak, ilustrasi datar, latar krem, tanpa teks",
     "source": ""},
    {"id": 5, "beat": "dampak", "seconds": 9, "motion": "zoom-in",
     "narration": "Karena es lebih renggang, ia lebih ringan untuk volume yang sama. Itu sebabnya ia naik dan mengapung di atas air.",
     "on_screen": "Lebih renggang, jadi mengapung",
     "visual_prompt": "Potongan es mengapung dengan sebagian kecil di atas permukaan air, tampak samping, ilustrasi datar, tanpa teks",
     "source": ""},
    {"id": 6, "beat": "batas", "seconds": 7, "motion": "static",
     "narration": "Penjelasan ini berlaku untuk air murni pada tekanan biasa. Kondisi lain bisa mengubah detailnya.",
     "on_screen": "Berlaku untuk air murni",
     "visual_prompt": "Kartu catatan krem dengan ikon tetes air dan termometer, ilustrasi datar, tanpa teks",
     "source": ""},
    {"id": 7, "beat": "penutup", "seconds": 8, "motion": "zoom-in",
     "narration": "Jadi es mengapung karena air membeku jadi lebih renggang. Menurut kamu, benda apa lagi yang sifatnya aneh begini?",
     "on_screen": "Benda apa lagi?",
     "visual_prompt": "Gelas bening dengan es mengapung dan tanda tanya kecil di samping, ilustrasi datar, latar krem, tanpa teks",
     "source": ""}
  ]
}
Kolom on_screen adalah judul besar yang kamu tambahkan di editor atau overlay. Script di bawah tidak merendernya. Kolom source yang diawali TODO memicu peringatan.
plan_check.py (hanya Python 3, tanpa paket tambahan):
plan_check.py:
#!/usr/bin/env python3
"""Cek scenes.json, lalu tulis narration.txt, subtitle.srt, dan motion.csv ke folder keluaran."""
import argparse
import json
import re
import sys
from pathlib import Path

MIN_WPS, MAX_WPS = 1.8, 2.6  # kata per detik, kira-kira 108-156 kata per menit
MOTIONS = {"zoom-in", "zoom-out", "pan-left", "pan-right", "static"}
REQUIRED = ("id", "beat", "seconds", "motion", "narration", "on_screen", "visual_prompt", "source")


def srt_time(t):
    ms = round(t * 1000)
    h, ms = divmod(ms, 3_600_000)
    m, ms = divmod(ms, 60_000)
    s, ms = divmod(ms, 1000)
    return f"{h:02d}:{m:02d}:{s:02d},{ms:03d}"


def chunk(words, size=5):
    return [words[i:i + size] for i in range(0, len(words), size)]


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("plan")
    ap.add_argument("--out", default="build")
    args = ap.parse_args()

    plan = json.loads(Path(args.plan).read_text(encoding="utf-8"))
    out = Path(args.out)
    out.mkdir(parents=True, exist_ok=True)
    errors, warnings = [], []
    total = 0.0
    cues, narration, motion_rows = [], [], []
    cue_no = 1

    for scene in plan["scenes"]:
        sid = scene.get("id", "?")
        missing = [k for k in REQUIRED if k not in scene]
        if missing:
            errors.append(f"scene {sid}: field hilang {missing}")
            continue
        if scene["motion"] not in MOTIONS:
            errors.append(f"scene {sid}: motion '{scene['motion']}' tidak dikenal, pilih {sorted(MOTIONS)}")
        words = re.findall(r"\S+", scene["narration"])
        sec = float(scene["seconds"])
        wps = len(words) / sec
        if not MIN_WPS <= wps <= MAX_WPS:
            warnings.append(f"scene {sid}: {wps:.2f} kata/detik di luar {MIN_WPS}-{MAX_WPS}; ubah naskah atau durasi")
        if "TODO" in scene["source"]:
            warnings.append(f"scene {sid}: sumber belum diisi")
        narration.append(scene["narration"])
        motion_rows.append(f"{sid},{sec:g},{scene['motion']}")
        parts = chunk(words)
        step = sec / len(parts)
        for i, part in enumerate(parts):
            start = total + i * step
            cues.append(f"{cue_no}\n{srt_time(start)} --> {srt_time(start + step)}\n{' '.join(part)}\n")
            cue_no += 1
        total += sec

    lo, hi = plan["min_seconds"], plan["max_seconds"]
    if not lo <= total <= hi:
        errors.append(f"total {total:.0f} dtk di luar rentang {lo}-{hi}")

    (out / "narration.txt").write_text("\n\n".join(narration) + "\n", encoding="utf-8")
    (out / "subtitle.srt").write_text("\n".join(cues), encoding="utf-8")
    (out / "motion.csv").write_text("\n".join(motion_rows) + "\n", encoding="utf-8")

    print(f"{len(plan['scenes'])} scene, total {total:.0f} dtk")
    for w in warnings:
        print("WARN ", w)
    for e in errors:
        print("ERROR", e)
    sys.exit(1 if errors else 0)


if __name__ == "__main__":
    main()
Jalankan:
python3 -I plan_check.py scenes.json --out buildHasil dengan contoh di atas:
7 scene, total 55 dtk
WARN  scene 2: sumber belum diisi
WARN  scene 3: sumber belum diisi
Script menulis tiga berkas ke build/: narration.txt untuk dibacakan TTS, subtitle.srt dengan maksimal 5 kata per cue, dan motion.csv untuk tahap gerak. Waktu subtitle dibagi rata per scene, jadi perkiraan saja. Kalau ingin tepat per kata, sunting di editor setelah suara final.
8. Aset visual AI
Terlihat: pada frame awal, 9 dari 12 Reel memakai ilustrasi 2D datar, dan 8 di antaranya dengan karakter atau maskot. Karakter yang sama dipakai ulang antar-Reel dalam satu topik: maskot tanda tanya di tiga Reel, karakter matahari untuk Sol di dua Reel, karakter bola untuk Argon di dua Reel. Latarnya polos, hangat atau gelap, objek utamanya besar, dan jumlah elemen per frame sedikit.
Inferensi: konsistensi karakter menandakan ada aturan gaya yang dipegang, entah berupa gambar buatan tangan, template, atau generator. Data yang ada tidak menunjukkan yang mana.
Saran: tulis satu “style bible” dan tempelkan di setiap prompt gambar. Teks jangan diminta dari generator gambar. Tambahkan teks sebagai lapisan terpisah, supaya ejaan dan angkanya terjamin.
STYLE BIBLE (tempel di awal setiap prompt gambar)
Gaya: ilustrasi datar 2D, bentuk sederhana, garis tepi tebal warna navy tua, tanpa gradasi rumit.
Palet: krem hangat untuk latar, navy tua, hijau sage, satu warna aksen kuning.
Karakter: [NAMA KARAKTER], [bentuk dasar, jumlah mata, warna], ekspresi terbaca dari jauh.
Kamera: tampak depan, objek utama di tengah, sepertiga bawah kosong untuk subtitle.
Rasio: 9:16 vertikal.
Larangan: tanpa teks, tanpa huruf, tanpa logo, tanpa watermark, tanpa tangan atau jari yang rumit.
[TEMPEL STYLE BIBLE]
Scene [NOMOR]: [isi visual_prompt dari scenes.json]
Posisi objek utama: [tengah / kiri / kanan].
Ruang kosong: sepertiga bawah.
Keluaran: 1080x1920 atau rasio 9:16 yang bisa diskalakan ke 1080x1920.Simpan hasilnya sebagai assets/scene-01.png, assets/scene-02.png, dan seterusnya. Nomor harus sama dengan id di scenes.json. Sebelum lanjut, periksa tiga hal: karakter tetap sama antar-scene, tidak ada teks acak di gambar, dan hak pakai gambar dari layananmu mengizinkan penggunaan yang kamu rencanakan.
9. Suara tanpa rekaman (TTS)
Terlihat: 11 dari 12 Reel bernarasi dengan kecepatan sekitar 123 kata per menit, tanpa jeda panjang di awal. Caption satu Reel menulis “VO & animasi dibantu AI”. Jenis suara pada Reel lain tidak bisa dipastikan.
Saran: render suara per scene, bukan satu file panjang. Dengan begitu kamu bisa mengganti satu kalimat tanpa mengulang semuanya, dan durasi tiap scene mengikuti suara yang sebenarnya.
- Pilih layanan TTS yang mendukung bahasa Indonesia dan mengizinkan pemakaian komersial di akunmu. Baca syarat lisensinya sebelum memakai suara di video yang dipublikasikan.
- Ambil
build/narration.txt, lalu eja ulang bagian yang sering salah baca: singkatan, nama merek, dan angka. - Render tiap scene jadi
assets/voice/scene-01.wav,scene-02.wav, dan seterusnya. - Dengarkan semuanya lewat speaker ponsel, bukan hanya headphone.
- Ukur durasi tiap file, lalu sesuaikan
secondsdiscenes.jsonkalau suara lebih panjang. Jalankanplan_check.pylagi.
voice_pad.sh memberi hening di ujung tiap scene sampai pas dengan seconds, lalu menggabungkannya. Kalau suara lebih panjang dari scene-nya, script berhenti dan memberi tahu scene mana:
voice_pad.sh:
#!/usr/bin/env bash
# Samakan panjang suara tiap scene dengan durasi di scenes.json, lalu gabung jadi assets/voice.wav.
# Pakai: bash voice_pad.sh   (butuh assets/voice/scene-01.wav, scene-02.wav, ... dan build/motion.csv)
set -euo pipefail
mkdir -p build/voice-padded

while IFS=, read -r id seconds motion; do
  n=$(printf '%02d' "$id")
  src="assets/voice/scene-${n}.wav"
  [ -f "$src" ] || { echo "Suara tidak ada: $src" >&2; exit 1; }
  real=$(ffprobe -v error -show_entries format=duration -of csv=p=0 "$src")
  if awk -v r="$real" -v s="$seconds" 'BEGIN { exit !(r > s) }'; then
    echo "scene-${n}: suara ${real} dtk lebih panjang dari ${seconds} dtk. Naikkan seconds atau ringkas naskah." >&2
    exit 1
  fi
  ffmpeg -nostdin -y -loglevel error -i "$src" -af "apad=whole_dur=${seconds}" -ar 44100 -ac 1 "build/voice-padded/scene-${n}.wav"
  echo "scene-${n}: suara ${real} dtk, diberi hening sampai ${seconds} dtk"
done < build/motion.csv

printf "file '%s'\n" "$PWD"/build/voice-padded/scene-*.wav > build/voice.txt
ffmpeg -nostdin -y -loglevel error -f concat -safe 0 -i build/voice.txt -c copy assets/voice.wav
echo "Selesai: assets/voice.wav"
Kalau sebuah Reel memakai suara hasil AI, tulis itu di caption. Caption “VO & animasi dibantu AI” pada Reel tarif Haiku 5.5 adalah contoh kalimat pengungkapan yang singkat.
10. Motion
Terlihat: pembuat Reel uji model menilai gerak hasil kedua model “masih lumayan sederhana”. Dari urutan frame awal Reel lain, terlihat objek yang masuk dari tepi layar dan teks yang berganti kata demi kata. Gerak karakter tidak bisa dinilai dari frame diam.
Saran: mulai dari gerak kamera halus pada gambar diam. Zoom pelan, geser kiri atau kanan, atau diam. Cara ini murah, stabil, dan tidak membutuhkan model video. Model gambar-ke-video bisa ditambahkan nanti untuk beberapa scene penting, dan hasilnya perlu diperiksa untuk karakter yang berubah-ubah.
motion.sh membaca build/motion.csv, memperbesar gambar dua kali lebih dulu supaya gerakannya tidak bergetar, lalu menulis satu klip per scene:
motion.sh:
#!/usr/bin/env bash
# Ubah assets/scene-01.png, scene-02.png, ... jadi klip 1080x1920 dengan gerak kamera halus.
# Pakai: bash motion.sh   (butuh build/motion.csv dari plan_check.py)
set -euo pipefail
FPS=30
mkdir -p build/clips

while IFS=, read -r id seconds motion; do
  n=$(printf '%02d' "$id")
  img="assets/scene-${n}.png"
  [ -f "$img" ] || { echo "Aset tidak ada: $img" >&2; exit 1; }
  frames=$(awk -v s="$seconds" -v f="$FPS" 'BEGIN { printf "%d", s * f + 0.5 }')
  center_x='iw/2-(iw/zoom/2)'
  center_y='ih/2-(ih/zoom/2)'
  case "$motion" in
    zoom-in)   z="min(1+0.15*on/${frames},1.15)"; x="$center_x"; y="$center_y" ;;
    zoom-out)  z="max(1.15-0.15*on/${frames},1)"; x="$center_x"; y="$center_y" ;;
    pan-left)  z="1.15"; x="(iw-iw/zoom)*(1-on/${frames})"; y="$center_y" ;;
    pan-right) z="1.15"; x="(iw-iw/zoom)*on/${frames}"; y="$center_y" ;;
    static)    z="1"; x="$center_x"; y="$center_y" ;;
  esac
  ffmpeg -nostdin -y -loglevel error -loop 1 -i "$img" \
    -vf "scale=2160:3840:flags=lanczos,zoompan=z='${z}':x='${x}':y='${y}':d=${frames}:s=1080x1920:fps=${FPS},format=yuv420p" \
    -frames:v "$frames" -c:v libx264 -crf 18 -preset medium "build/clips/scene-${n}.mp4"
  echo "scene-${n}: ${frames} frame, ${motion}"
done < build/motion.csv
Catatan: pada tes, tujuh scene (55 detik) selesai sekitar satu menit di satu mesin Linux dengan FFmpeg 6.1. Waktunya akan berbeda di perangkatmu.
11. Subtitle
Terlihat: pada frame awal, 11 dari 11 Reel bernarasi menampilkan teks besar di layar. Beberapa menampilkan kata kunci satu per satu dengan sorot warna, sebagian lain menampilkan frasa pendek sebagai judul.
Saran: maksimal 5 kata per cue dan dua baris, huruf tebal dengan garis tepi, di atas zona yang tertutup tombol dan caption platform. plan_check.py sudah menulis SRT dengan batas itu. Gaya sorot kata demi kata sebaiknya dibuat di editor atau lewat berkas ASS, karena script di sini tidak membuatnya. Setelah suara final, putar ulang video dan perbaiki waktu cue yang bergeser.
12. Musik dan SFX
Bagian ini seluruhnya Saran, karena musik di 12 Reel tidak dianalisis.
- Pakai musik berlisensi yang jelas. Catat nama lagu, pembuat, sumber, dan lisensinya di ledger proyekmu.
- Taruh musik jauh di bawah suara, lalu biarkan ia turun otomatis saat narasi berbunyi (ducking).
assemble.shmelakukannya dengansidechaincompress. - Pakai efek suara seperlunya, misalnya satu bunyi pada angka penting. Terlalu banyak efek mengganggu narasi.
13. Render dan cek teknis
assemble.sh menggabungkan klip, suara, subtitle, dan musik opsional jadi build/final.mp4. Loudness suara diseragamkan ke sekitar -16 LUFS. Itu pilihan umum yang cukup aman, bukan angka yang diwajibkan platform, jadi cek sendiri pedoman terbaru platform tujuanmu.
assemble.sh:
#!/usr/bin/env bash
# Gabung klip, suara, musik (opsional), dan subtitle jadi final.mp4 vertikal.
# Pakai: bash assemble.sh                 (suara saja)
#        bash assemble.sh assets/music.mp3  (dengan musik di bawah suara)
set -euo pipefail
VOICE="assets/voice.wav"
MUSIC="${1:-}"
[ -f "$VOICE" ] || { echo "Tidak ada $VOICE" >&2; exit 1; }

: > build/clips.txt
for f in build/clips/scene-*.mp4; do echo "file 'clips/$(basename "$f")'" >> build/clips.txt; done
ffmpeg -y -loglevel error -f concat -safe 0 -i build/clips.txt -c copy build/video-raw.mp4

DUR=$(ffprobe -v error -show_entries format=duration -of csv=p=0 build/video-raw.mp4)
# Satuan force_style untuk SRT mengikuti kanvas 288 piksel tinggi: FontSize=14 kira-kira 93 px di 1920, MarginV=60 kira-kira 400 px dari bawah.
SUB="subtitles=build/subtitle.srt:force_style='FontSize=14,Bold=1,Alignment=2,MarginV=60,Outline=1,Shadow=0,PrimaryColour=&H00FFFFFF,OutlineColour=&H00202020'"

if [ -n "$MUSIC" ]; then
  ffmpeg -y -loglevel error -i build/video-raw.mp4 -i "$VOICE" -stream_loop -1 -i "$MUSIC" \
    -filter_complex "[1:a]asplit=2[voice][key];[2:a]volume=0.35[bed];[bed][key]sidechaincompress=threshold=0.04:ratio=8:attack=20:release=400[ducked];[voice][ducked]amix=inputs=2:duration=first:dropout_transition=0,loudnorm=I=-16:TP=-1.5:LRA=11[aout];[0:v]${SUB}[vout]" \
    -map "[vout]" -map "[aout]" -t "$DUR" \
    -c:v libx264 -crf 18 -preset medium -pix_fmt yuv420p -r 30 -c:a aac -b:a 192k -movflags +faststart build/final.mp4
else
  ffmpeg -y -loglevel error -i build/video-raw.mp4 -i "$VOICE" \
    -filter_complex "[1:a]loudnorm=I=-16:TP=-1.5:LRA=11[aout];[0:v]${SUB}[vout]" \
    -map "[vout]" -map "[aout]" -t "$DUR" \
    -c:v libx264 -crf 18 -preset medium -pix_fmt yuv420p -r 30 -c:a aac -b:a 192k -movflags +faststart build/final.mp4
fi
echo "Selesai: build/final.mp4"
Jalankan:
bash motion.sh
bash voice_pad.sh
bash assemble.sh                     # suara saja
bash assemble.sh assets/music.mp3    # dengan musik
qa.sh mencetak resolusi, fps, codec, durasi, dan loudness:
qa.sh:
#!/usr/bin/env bash
# Cek teknis final.mp4: resolusi, fps, codec, durasi, dan loudness.
set -euo pipefail
F="${1:-build/final.mp4}"
ffprobe -v error -show_entries stream=codec_name,width,height,r_frame_rate,pix_fmt -show_entries format=duration -of default=nw=1 "$F"
ffmpeg -hide_banner -nostats -i "$F" -af ebur128=peak=true -f null - 2>&1 | sed -n '/Summary:/,$p'
Hasil pada tes dengan aset sintetis (gambar polos dan nada sinus, bukan TTS sungguhan):
codec_name=h264
width=1080
height=1920
pix_fmt=yuv420p
r_frame_rate=30/1
codec_name=aac
duration=55.000000
Integrated loudness: I: -16.0 LUFS
14. Checklist QA
Salin ke catatan proyekmu dan centang satu per satu.
- [ ] Setiap angka, nama, dan tanggal di video cocok dengan lembar fakta.
- [ ] Setiap klaim punya sumber, dan sumber itu tampil di layar atau di caption.
- [ ] plan_check.py selesai tanpa ERROR dan tanpa WARN sumber.
- [ ] Karakter dan gaya konsisten dari scene pertama sampai terakhir.
- [ ] Tidak ada teks acak, huruf rusak, atau watermark di gambar.
- [ ] Nama merek dan angka terdengar benar di TTS.
- [ ] Suara tidak terpotong di akhir scene.
- [ ] Subtitle terbaca di layar ponsel dan tidak tertutup UI platform.
- [ ] Musik tidak menutupi suara.
- [ ] Lisensi gambar, suara, dan musik dicatat.
- [ ] qa.sh: 1080x1920, h264, yuv420p, 30 fps, aac.
- [ ] Video ditonton penuh di ponsel, dengan suara menyala.
- [ ] Caption tidak menjanjikan hasil, jangkauan, atau penghematan yang tidak terbukti.
- [ ] Pengungkapan AI ditulis di caption atau lewat label platform.
15. Publikasi
Terlihat: caption pada 12 Reel itu umumnya ringkas. Beberapa memuat sumber, beberapa menautkan video panjang di YouTube, tiga mengkredit kolaborator, dan 9 dari 12 memakai 4 sampai 6 hashtag.
Template caption berikut adalah Saran:
[JUDUL SINGKAT BERUPA PERTANYAAN ATAU KLAIM]

[1 sampai 2 kalimat inti yang cocok dengan video]

Sumber: [nama sumber, tanggal]
[Suara dan animasi dibantu AI.]

[Satu pertanyaan untuk penonton]

[4 sampai 6 hashtag yang relevan]
Sebelum menekan unggah, bandingkan caption dengan lembar fakta sekali lagi. Pakai label AI dari platform kalau tersedia, dan ikuti kebijakan terbaru platform yang kamu pakai. Jangan menulis angka performa atau biaya di caption kalau kamu belum mengukurnya.
16. Kegagalan umum dan perbaikan
Tiga baris pertama terjadi saat script di panduan ini diuji.
- Loop di
motion.shhanya memproses scene pertama.ffmpegmembaca stdin dan menelan sisamotion.csv. Pakaiffmpeg -nostdindi dalam loopwhile read. concatgagal membukabuild/scene-01.mp4. Path di daftar concat dihitung dari lokasi berkas daftar. Tulisfile 'clips/scene-01.mp4'relatif terhadapbuild/.- Subtitle tidak terlihat sama sekali.
FontSizedanMarginVuntuk SRT memakai kanvas 288 piksel tinggi, bukan piksel video. PakaiFontSize=14danMarginV=60, jangan 62 dan 420. - Zoom terlihat bergetar. Gambar kecil di-zoom langsung. Perbesar gambar dua kali dulu seperti di
motion.sh. - Suara terpotong di akhir scene. Durasi
secondslebih pendek dari suara.voice_pad.shakan menolak, jadi naikkanseconds. - TTS salah baca nama merek atau angka. Teks ditulis seperti ejaan tulis. Eja ulang sesuai lafal di
narration.txt. - Karakter berubah antar-scene. Style bible tidak ikut di prompt. Tempel style bible lengkap di setiap prompt.
17. Batas panduan ini
- Alur di bagian 7 sampai 13 adalah rancangan penulis, bukan salinan alur kreator mana pun.
- Script diuji dengan FFmpeg 6.1 dan Python 3.11 memakai gambar dan nada sinus sintetis. Belum diuji dengan TTS sungguhan atau generator gambar tertentu.
- Panduan ini tidak menyebut angka biaya, kuota, atau waktu produksi dari Reel mana pun sebagai patokan. Harga dan lisensi layanan berubah, jadi periksa halaman resmi pada hari kamu berlangganan.
- Nama model pada judul Reel di Lampiran A adalah topik Reel itu sendiri, bukan rekomendasi atau klaim tentang model tersebut.
- Pola di bagian 2 berasal dari 12 Reel, rentang 30 Agustus sampai 9 Oktober 2026. Itu sampel kecil, dan tidak bisa dibaca sebagai penyebab jangkauan atau engagement. Angka suka dan komentar sengaja tidak dipakai.
Lampiran A. Ledger 12 Reel
Semua tautan membuka Reel asli di Instagram. Format dan durasi diukur dari file, tanggal dari metadata unggahan (UTC). Urutan dari yang terbaru.
- Adu model termurah: @taugaksih31, 2026-10-09, 3:4 (1080x1440), 107,5 detik.
- Ijazah calon pejabat: @taugaksih31, 2026-10-09, 9:16 (1080x1920), 56,9 detik.
- Tarif Haiku 5.5: @taugaksih31, 2026-10-08, 9:16 (1080x1920), 67,1 detik.
- 8 berita AI mingguan: @taugaksih31, 2026-10-06, 9:16 (1080x1920), 106,8 detik.
- Luas alam semesta: @taugaksih31, 2026-10-03, 9:16 (1080x1920), 60,0 detik.
- Sol 6.1 vs Argon: @jakintegral, 2026-10-03, 9:16 (1080x1920), 70,3 detik.
- Pusat data dan air: @taugaksih31, 2026-10-02, 9:16 (720x1280), 144,5 detik.
- Gemini 4 Argon: @jakintegral, 2026-10-01, 9:16 (1080x1920), 73,4 detik.
- GPT 6.1 Sol: @jakintegral, 2026-10-01, 9:16 (1080x1920), 72,6 detik.
- Kenalan Tau Gak Sih: @taugaksih31, 2026-09-29, 16:9 (1920x1080), 36,5 detik.
- Opus 5.5 vs Sol: @jakintegral, 2026-09-27, 16:9 (1920x1080), 90,0 detik.
- Hunting The Dragon: @yourewerethere, 2026-08-30, 16:9 (1280x720), 174,6 detik.
Berkas ledger lengkap, termasuk kolom hasil pengkodean manual, ada di repositori situs: docs/guide-source-ledgers/video-pendek-full-ai-taugaksih31.md dan berkas .data.json.
Lampiran B. Ledger visual
- Embed Reel tarif Haiku 5.5: embed resmi Instagram dari Reel DeOJ4sKuzuc oleh @taugaksih31. Menjawab seperti apa format yang dibedah.
- Diagram durasi 12 Reel: visual penjelas orisinal dari pengukuran ffprobe atas 12 Reel, dibuat oleh
scripts/guides/taugaksih31-figures.mjs. Menjawab berapa lama durasi yang wajar. - Peta beat Reel 67 detik: visual penjelas orisinal dari transkrip bertimestamp Reel DeOJ4sKuzuc, dengan nama beat dari penulis. Menjawab apa isi tiap bagian Reel satu menit.
- Sampul kartu daftar panduan: visual orisinal tanpa konten pihak ketiga, dibuat oleh
scripts/guides/taugaksih31-figures.mjs. Ringkasan empat tahap di kartu daftar.
Tidak ada frame, tangkapan layar, atau video pihak ketiga yang disimpan di situs ini.